1. AES 암호란?
AES(Advanced Encryption Standard)는 2001.2.에 NIST에 의해 연방 정보처리 표준으로 지정된 대칭키 암호화 방법입니다.
AES 암호화는 SPN(Substitution Permutation Network) 이라는 암호화 구조를 따릅니다. SPN는 S-Box를 사용하는 치환과 P-Box를 사용하는 순열을 여러 각 라운드별로 거쳐서 반복됩니다. 단 Feistel구조를 따르지 않는다는 점이 특징이다.
Feistel 구조를 따르지 않고 SPN구조를 따른다는건 약 두배의 암호학적인 안정성을 갖는다는 뜻입니다.
각 라운드는 “layer”라고 불리는 3개로 나뉘어 별개의 발전된 변환 구조를 기초를 두고 있습니다.
- Linear mixing layer : 안정된 높은 확산 효과
- Non-Linear layer : S-Box의 병렬 애플리케이션
- Key addition layer : 중간 상태의 라운드 키와 XOR 연산
Feistel 구조란
> 블록을 절반(L, R)으로 나눠, **한쪽에만 라운드 함수 F를 적용하고 다른 쪽과 XOR한 뒤 좌우를 교환**하는 과정을 여러 라운드 반복하는 블록암호 설계 방식
AES는 128비트의 블록을 암호화하는 블록 암호로써 키의 길이는 128, 192, 256비트 중 1개를 선택할수 있습니다. 라운드의 수는 키의 길이에 다라 10,12,14로 결정됩니다.
AES 파라미터 (byte 기준)
| 키 길이 | 16 | 24 | 32 |
|---|---|---|---|
| 평문 블록 사이즈 | 16 | 16 | 16 |
| 라운드 수 | 10 | 12 | 14 |
| 라운드 키 길이 | 16 | 16 | 16 |
| 확장 키 길이 | 176 | 208 | 240 |
2. AES 구조
128비트의 키를 사용하며 총 10개의 라운드로 구성이 되어 있습니다. 128비트의 평문을 받아서 128비트의 암호문을 출력하는 단일 블록 암호 알고르즘입니다.
AES 암호는 다음 4가지 동작을 반복적으로 수행합니다.
- SubBytes : 바이트 대치
- ShiftRows : 행 이동
- MixColumns : 열 혼합
- AddRoundKey. : 라운드 키 추가
이런 AES는 복호화 과정에서 usubBytes, ShiftRows, MixColumns 각 3가지 단계를 거꾸로 수행하는 단계 3개를 거칩니다.
- InvSubBytes
- InvShiftRows
- InvMixColumns
이런 AES 암호화 재밌는 특징중 1개는 SubBytes와 ShiftRows의 순서가 바껴도 결과에 영향이 없다는점 입니다. 또한 MixColumns, AddRoundKey 연산도 순서를 바꿀수 있다는 점입니다.
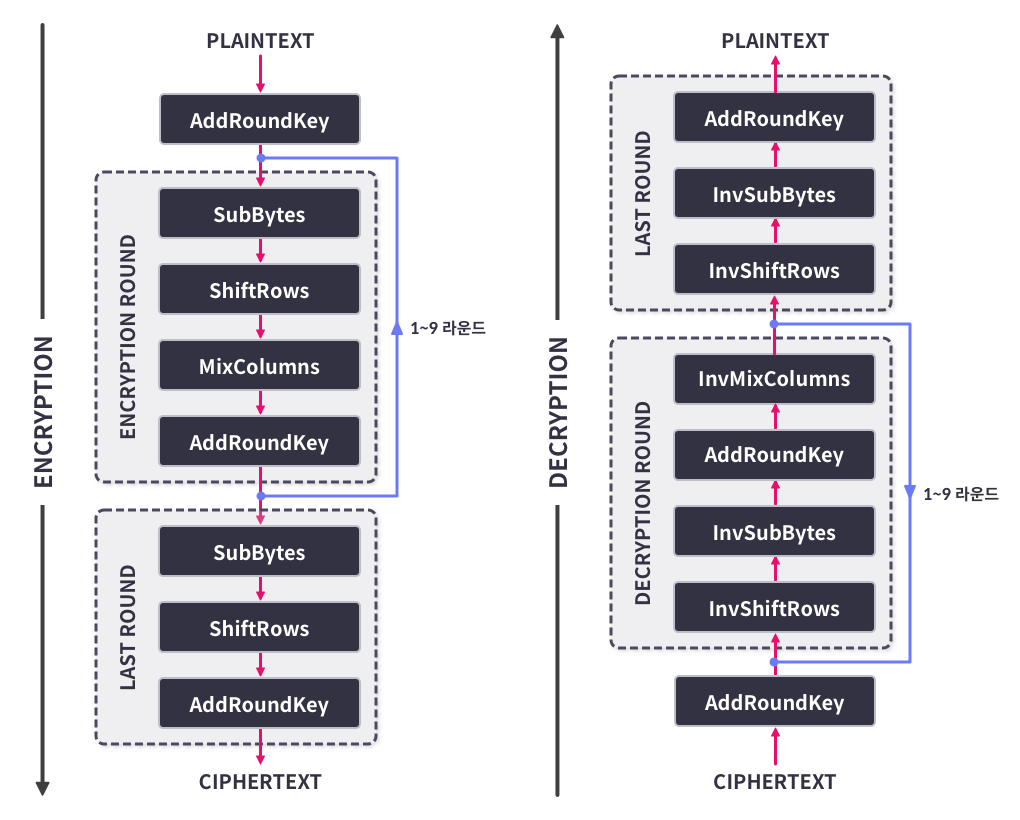
AES에서 키는 128비트이다 하지만 이런 키는 Expand key를 단계를 거치며 각 라운드에 사용될 키들로 확장된다. 즉 128bit = 4word인데 이것이 11개 생기는것 이다. 따라서 전체 키는 44 word인 것이다. 이런 AES에서 사용되는 키를 주로 32비트씩 워드 단위로 나누거나 4개의 바이트씩 나눠서 표현한다. 대부분은 데이터 처리는 바이트로 표현되는 블록 바이트를 정방 상태 배열로 표현한다.
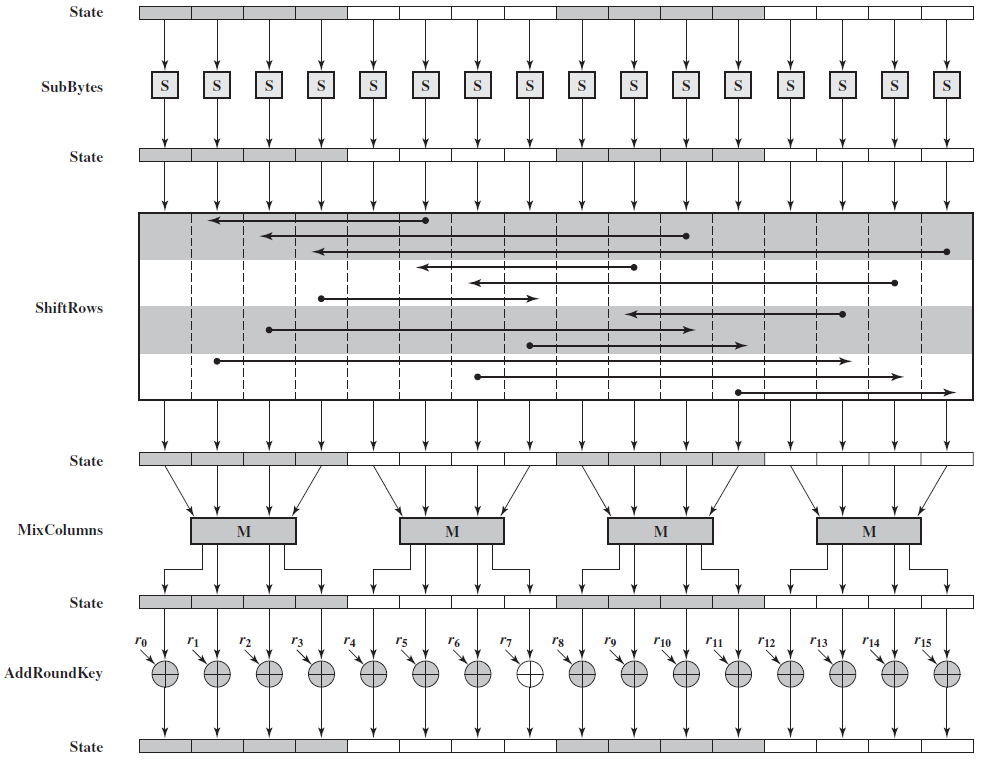
위 사진은 이런 AES 암호화에서 한 라운드의 과정을 시각화한 사진입니다.
- 라운드 입력으로 들어온 16개 바이트를 대치 암호화하는 SubBytes 과정
- 상태 행끼리 일정한 회수만큼 회전하는 ShiftRows 과정
- 열끼리 바이트 단위로 혼합하는 MixColumns 과정
- 상태 값과 라운드 키를 단위로 XOR 하는 AddRoundKey 과정
3. 각 라운드별 함수 설명
3-1. SubBytes & InvSubBytes
SubBytes 동작원리
SubBytes는 암호화 과정에서 생기는 대치 바이트 변환을 뜻합니다. SubBytes는 테이블 룩업을 이용해서 S-Box라고 불리는 대치효에 따라 한 바이트의 출력을 내고 있습니다.
S-Box는 16x16의 크기를 가진 표로써 세로를 x, 가로를 y라고 하면, 한 바이트에서 왼쪽과 오른쪽으로 반반 4bit씩 나눴을때, 왼쪽 값을 x로 오른쪽 값을 y로 두어 인덱스로 값을 구하는 방식으로 값을 정할수 있다.
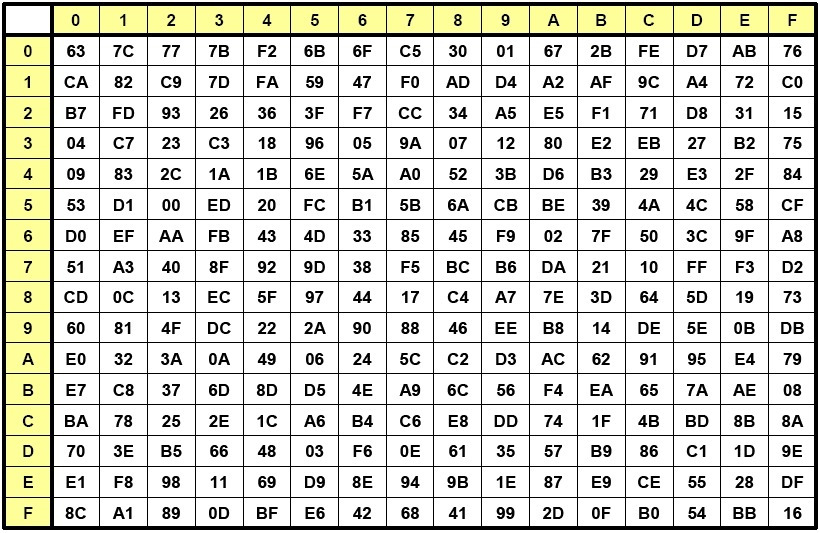
InvSubBytes 동작원리 및 표 없는 수학적 해독법
이런 SubBytes의 역함수인 InvSubBytes의 경우 SubBytes와 같은 방법인 표를 이용하는 방법도 있으나, 이는 메모리가 많이 필요하므로 실제 계산 과정을 구현하는 경우도 있습니다.
식을 갖는 체를 이용하면 가능하다.
- 각 바이트에 대하여 그 바이트의 상의 곱셈의 역원을 구한다. 이떄 {00}의 역원은 존재하지 않으므로 자기 자신으로 매핑합니다.
- 역원의 결과 중 최상위 비트를 , 최하위 비트를 으로 푝하여 각 바이트를 나타냅니다.
- (이떄 di는 0110 0011이다.)
NOTE
> SubBytes를 공식화 하는 것은 역함수의 공식에서 '를 거꾸로 붙여주면 되며, ci는 0000 0101이다.
SubBytes의 이점 및 취약점
- 이점
- 암호의 선형성을 깨드려 분석을 까다롭게 만듦
- 혼돈의 요건 충족
- 취약점
- 치환 과정에서 사용되는 S-Box에 따라 차분 공격 혹은 선형 공격등의 취약한 경우가 있음
코드
void SubBytes(BYTE state[][4]) {
	int i,j;
	for(i=0;i<4;i++) {
		for(j=0;j<4;j++) {
			state[i][j] = S_box=[HIHEX(state[i][j])][LOWHEX(state[i][j])]
		}
	}
}

void Inv_SubBytes(BYTE state[][4]) {
	int i,j;
	for(i=0;i<4;i++){
		for(j=0;j<4;j++){
			state[i][j] = Inv_S_box[HIHEX(state[i][j])][LOWHEX(state[i][j])];
		}
	}
}
위 코드에서 HIHEX와 LOWEHEX는 각각 상위 4비트, 하위 4비트를 추출하는 define으로 정의된 매크로 함수이다.
3-2. ShiftRows & InvShiftRows
ShiftRows | InvShiftRows
ShiftRows는 쉬프트 순환 이동을 말하며, 첫 번째 0 행은 쉬프트를 하지 않고, 1번 행은 1번,2 번 행은 2번, 3번 행은 3번만큼 왼쪽으로 쉬프트 한다 InvShiftRows는 이런 과정을 반대로 시프트한다.
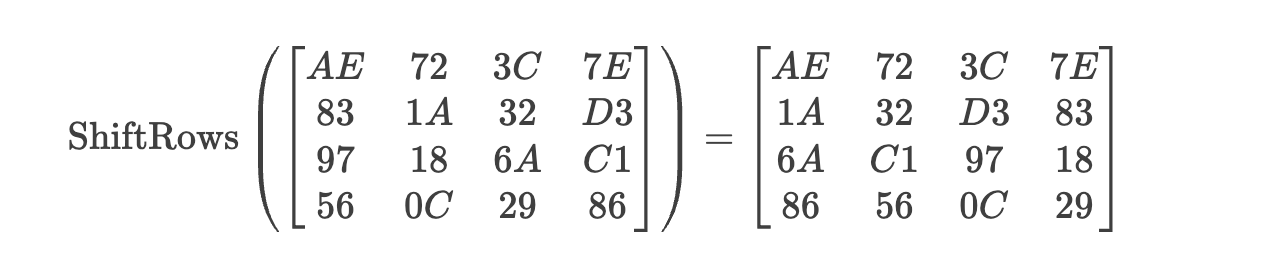
코드
void ShiftRows(BYTE state[][4]) {
	int i,j;
	for(i=1;i<4;i++) {
		for(j=0;j<i;j++){
			CirShiftRows(state[i]);
		}
	}
}

void CirShiftRows(BYTE* row) {
	BYTE temp = row[0];

	row[0] = row[1];
	row[1] = row[2];
	row[2] = row[3];
	row[3] = temp;
}

void Inv_ShiftRows(BYTE state[][4]) {
	int i,j;
	for(i=1;i<4;i++) {
		for(j=0;j<i;j++){
			Inv_CirShiftRows(state[i]);
		}
	}
}

void Inv_CirShiftRows(BYTE* row) {
	BYTE temp = row[3];

	row[3] = row[2];
	row[2] = row[1];
	row[1] = row[0];
	row[0] = temp;
}
3-3. MixColumns & InvMixColumns
MixColumns는 입력 블록의 각 열 단위로 치환을 수행한다.
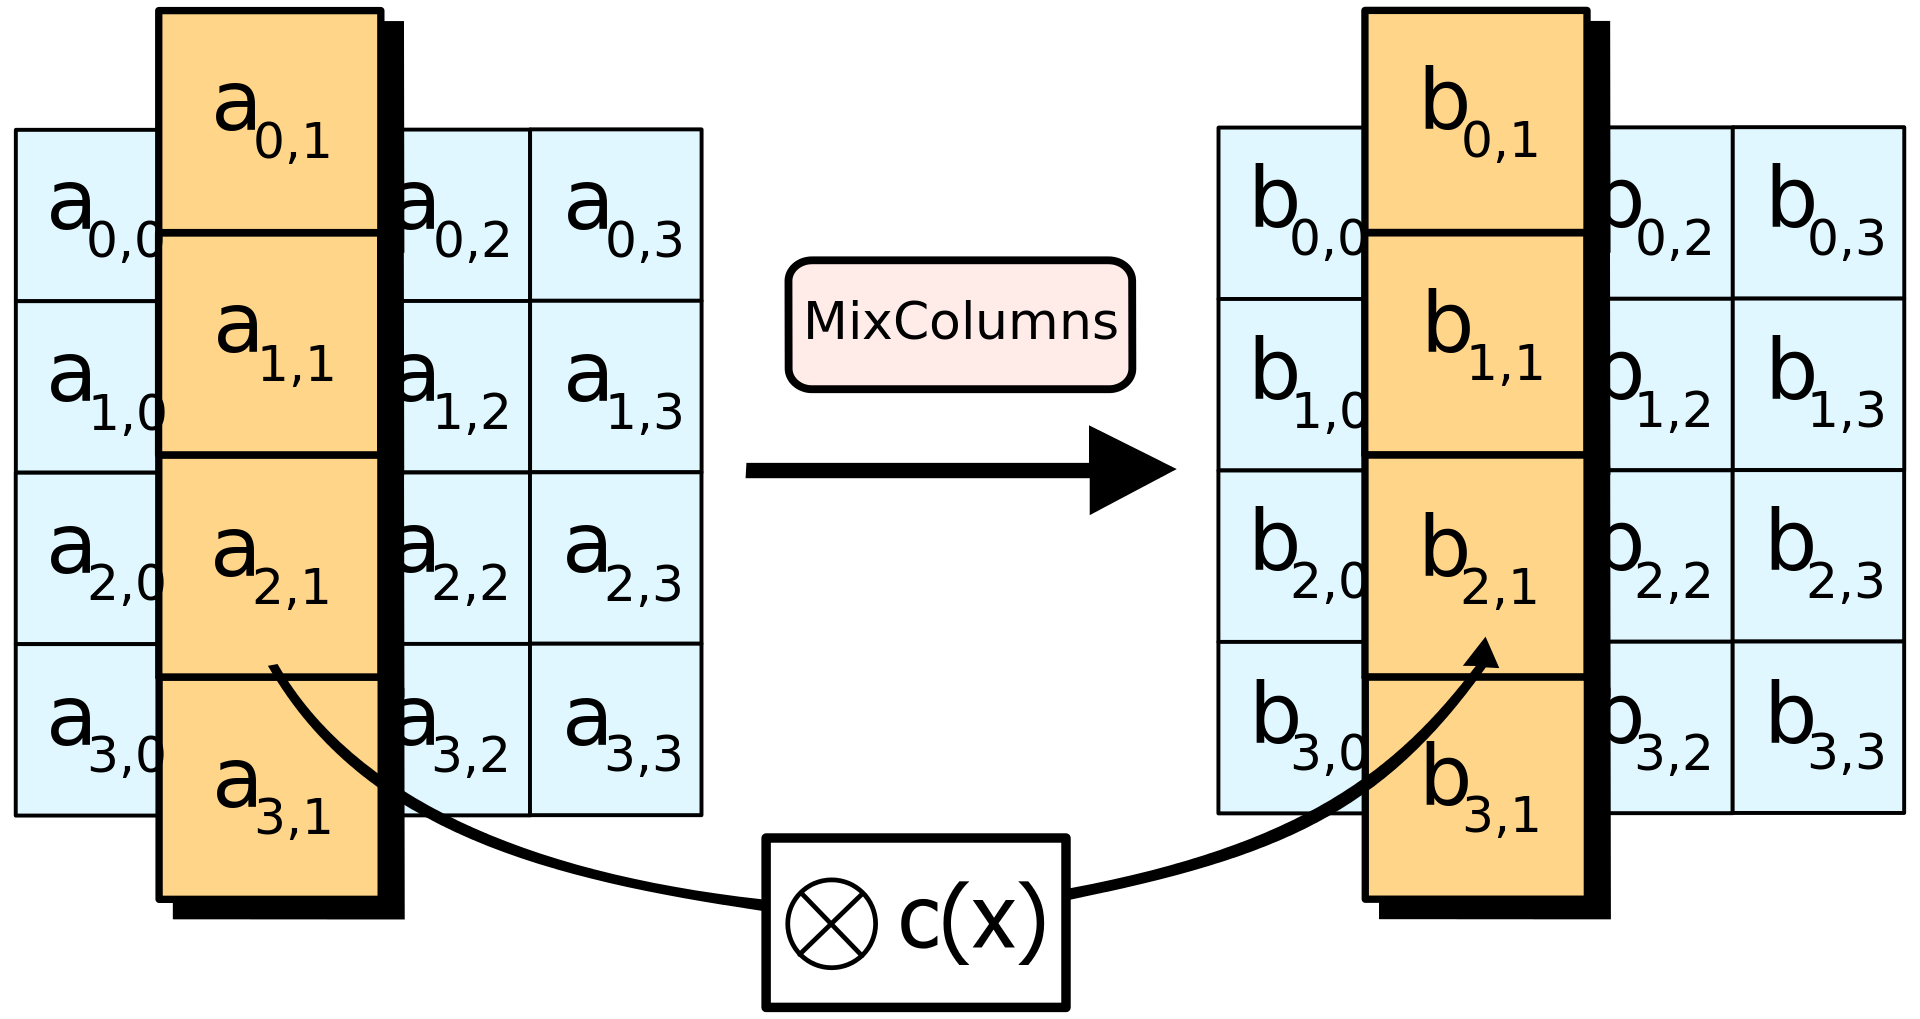
3-4. AddRoundKey
AddRoundKey는 각 입력 블록에 각 라운드 서브 키를 XOR합니다. 따라서 복호화 과정또한 동일한 라운드 서브 키를 이용해서 XOR를 수행하면 됩니다.
void AddRoundKey(BYTE state[][4], WORD* rKey) {
	int i,j;
	WORD mask, shift;

	for(i=0;i<4;i++){
		shift = 24;
		mask = 0xFF000000;
		for(j=0;j<4;j++){
			state[i][j] = ((rKey[i] & mask) >> shift) ^ state[i][j];
			mask >>= 8;
			shift -= 8;
		}
	}
}
3-5. Expand Key
Nk ⇐ 6 일 경우
KeyExpansion(byte key[4*Nk] word[Nb*(Nr+1]) {
	for(i=0;i<Nk;i++)
		W[i]=Key[4*i], Key[4*i+1], Key-4*i+2], Key[4*i+3]);

	for(i=Nk; i<Nb*(Nr+1); i++) {
		temp = W[i-1];
		if(i % Nk == 0)
			temp=SubByte(RotByte(temp)) ^ Rcon[i/Nk];
		W[i] = W[i-Nk] ^ temp;
	}
}
Nk > 6 일 경우
KeyExpansion(byte key[4*Nk] word[Nb*(Nr+1]) {
	for(i=0;i<Nk;i++)
		W[i]=Key[4*i], Key[4*i+1], Key-4*i+2], Key[4*i+3]);

	for(i=Nk; i<Nb*(Nr+1); i++) {
		temp = W[i-1];
		if(i % Nk == 0)
			temp=SubByte(RotByte(temp)) ^ Rcon[i/Nk];
		else if(i % Nk == 4)
			temp = SubByte(temp);
		W[i] = W[i-Nk] ^ temp;
	}
}
void KeyExpansion(BYTE* key, WORD* W) {
WORD temp;
int i = 0;
while(i < Nk) {
W[i] = BTOW(key[4*i], key[4*i+1], key[4*i+2], key[4*1+3]);
i += 1;
}
i = Nk;
while(i < (Nb * (Nr+1))) {
temp = W[i-1];
if(i%Nk == 0)
temp = SubWord(RotWord(temp)) ^ Rcon[i/Nk-1];
else if(NK > 6) && (i % Nk == 4)
temp = SubWord(temp);
W[i] = W[i-Nk] ^ temp;
i += 1;
}
}
WORD RotWord(WORD W) {
	reutrn ((W & 0xFF000000) >> 24) | (W << 8);
}
WORD SubWord(WORD W) {
int i;
WORD out = 0, mask = 0xFF000000;
BYTE shift = 24;
for(i=0;i<4;i++){
out += (WORD)S_box(HIHEX(W & mask) >> shift)[LOWHEX((W & mask) >> shift)] << shift;
mask >>= 8;
shift -= 8;
}
return out;
}